Teil 2 – Datenimport, Datenbereinigung und Datenmanagement
05 · Datenbank-Abfragen mit SQL
- Das relationale Datenmodell verstehen: Tabellen, Schlüssel, Beziehungen.
-
Die wichtigsten SQL-Befehle sicher anwenden:
SELECT,WHERE,JOIN,GROUP BYund Aggregatfunktionen (COUNT,AVG,MAX,SUM). -
SQL direkt über DuckDB auf CSV-Dateien ausführen, ohne Datenbankserver.
- Abfragen aus Python (
duckdb) und R (DBI+duckdb) heraus starten. - Den Unterschied zwischen
LEFT JOINundINNER JOINverstehen und richtig wählen.
Auf dieser Seite
Klinischer Aufhänger
Das Rechenzentrum gibt dir schreibgeschützten Zugriff auf die Klinikdatenbank, nur per SQL-Abfrage. Um die Frage „Unterscheidet sich das mittlere Laktat je nach
Aufnahmegrund?“ zu beantworten, musst du kohorte und labor verbinden und
gruppiert aggregieren. Mit SQL geht das in vier Zeilen.
1 Relationales Denken
Eine relationale Datenbank speichert Daten in mehreren Tabellen. Jede Tabelle hat einen Primärschlüssel (eindeutige ID je Zeile). Tabellen werden über Fremdschlüssel verknüpft.
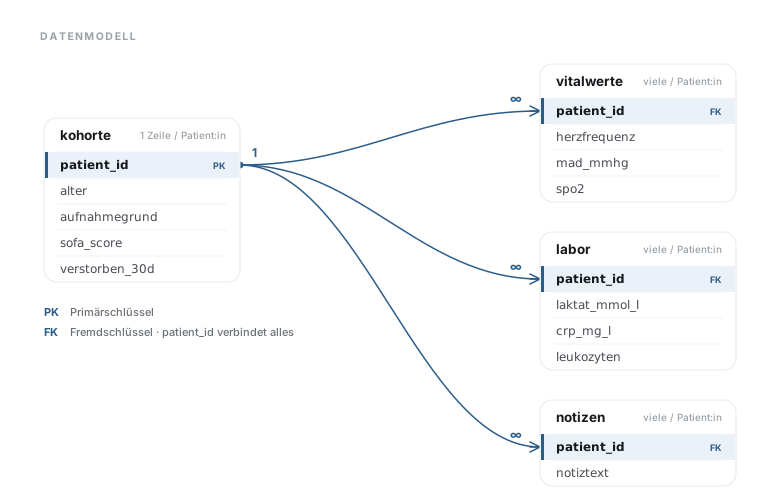
In unserem Datensatz ist patient_id der gemeinsame Schlüssel zwischen
kohorte.csv, labor.csv und vitalwerte.csv.
Mit DuckDB führst du SQL direkt auf CSV-Dateien aus, ohne Datenbankserver, ideal zum Erkunden.
Hat eine Tabelle mehrere Zeilen pro Patient:in (etwa vier
Messtage in vitalwerte), vervielfacht ein JOIN auf kohorte deren Zeilen.
Prüfe COUNT(*) vor und nach dem JOIN.
Für Fortgeschrittene
DuckDB unterstützt WINDOW-Funktionen (ROW_NUMBER(),
LAG(), LEAD()), mit denen sich Verlaufsdaten direkt in SQL analysieren lassen,
ohne erst nach Python oder R exportieren zu müssen.
2 SELECT, WHERE, ORDER BY
Die grundlegendste SQL-Abfrage:
SELECT patient_id, alter, aufnahmegrund, sofa_score
FROM kohorte
WHERE aufnahmegrund = 'Sepsis'
  AND sofa_score >= 6
ORDER BY sofa_score DESC
LIMIT 10;
Zeile für Zeile:
SELECT patient_id, alter, ...: Wähle die Spaltenpatient_id,alter,aufnahmegrundundsofa_scoreaus.FROM kohorte: Beziehe diese Spalten aus der Tabelle namenskohorte.WHERE aufnahmegrund = 'Sepsis' AND sofa_score >= 6: Filtere die Zeilen so, dass nur Patient:innen mit dem Aufnahmegrund'Sepsis'und einemsofa_scorevon mindestens 6 übrig bleiben.ORDER BY sofa_score DESC: Sortiere das Ergebnis nach demsofa_scorein absteigender Reihenfolge (höchster Score zuerst).LIMIT 10: Begrenze die Ausgabe auf maximal 10 Zeilen.
SELECT– welche Spalten?FROM– aus welcher Tabelle?WHERE– welche Zeilen? (Bedingungen mitAND,OR,NOT)ORDER BY– sortieren (Standard: aufsteigend,DESCfür absteigend)LIMIT– maximale Zeilenzahl
DuckDB öffnet eine Web-Adresse nur über seine Erweiterung httpfs (siehe
Fallstricke). Einfacher registrierst du ein pandas-DataFrame oder
R-data.frame, das du zuvor ganz normal (Modul 04) geladen hast. Das Muster in
diesem Modul ist deshalb: erst mit pandas/readr von
https://datascience.medizin.dev/data/ laden, dann bei DuckDB registrieren. Die con-Verbindung aus
diesem Abschnitt bleibt für den Rest des Moduls offen, alle folgenden
Abfragen bauen darauf auf.
In Python (DuckDB)
.py schreiben und mit dem ▶-Knopf in VS Code ausführen – oder Zeile für Zeile in die Python-Konsole. Setzt die in Modul 02 eingerichtete Umgebung voraus.import duckdb import pandas as pd cohort = pd.read_csv("https://datascience.medizin.dev/data/kohorte.csv") labor = pd.read_csv("https://datascience.medizin.dev/data/labor.csv") con = duckdb.connect(":memory:") con.register("kohorte", cohort) con.register("labor", labor) result = con.execute(""" SELECT patient_id, alter, aufnahmegrund, sofa_score FROM kohorte WHERE aufnahmegrund = 'Sepsis' AND sofa_score >= 6 ORDER BY sofa_score DESC LIMIT 10 """).df() print(result)
In R (DBI + duckdb)
library(DBI)
library(duckdb)
library(readr)

cohort <- read_csv("https://datascience.medizin.dev/data/kohorte.csv", show_col_types = FALSE)
labor  <- read_csv("https://datascience.medizin.dev/data/labor.csv", show_col_types = FALSE)

con <- dbConnect(duckdb::duckdb(), dbdir = ":memory:")
duckdb::duckdb_register(con, "kohorte", cohort)
duckdb::duckdb_register(con, "labor", labor)

result <- dbGetQuery(con, "
  SELECT patient_id, alter, aufnahmegrund, sofa_score
  FROM kohorte
  WHERE aufnahmegrund = 'Sepsis'
    AND sofa_score >= 6
  ORDER BY sofa_score DESC
  LIMIT 10
")
print(result)
dbConnect()/duckdb.connect() verbindet nur zu einer
DuckDB-Instanz, es lädt noch keine Daten. Erst con.register() /
duckdb_register() macht ein DataFrame unter einem Tabellennamen für SQL
sichtbar. Vergisst du diesen Schritt, meldet DuckDB Catalog Error: Table
with name kohorte does not exist.
3 Aggregation mit GROUP BY
Aggregatfunktionen fassen mehrere Zeilen zusammen:
| Funktion | Bedeutung |
|---|---|
COUNT(*) |
Anzahl Zeilen |
AVG(x) |
Mittelwert |
MEDIAN(x) |
Median (DuckDB unterstützt dies nativ) |
MIN(x) / MAX(x) |
Minimum / Maximum |
SUM(x) |
Summe |
GROUP BY teilt die Tabelle in Gruppen auf, bevor die Aggregatfunktion
angewendet wird. HAVING filtert anschließend auf Gruppenebene (analog zu
WHERE, aber nach der Aggregation).
SELECT
    aufnahmegrund,
    COUNT(*)               AS anzahl,
    ROUND(AVG(sofa_score), 1) AS sofa_mittel,
    ROUND(AVG(verstorben_30d) * 100, 1) AS mortalitaet_pct
FROM kohorte
GROUP BY aufnahmegrund
HAVING COUNT(*) >= 50
ORDER BY mortalitaet_pct DESC;
AVG(verstorben_30d) ergibt eine Proportion nur, weil das Feld
mit 0/1 kodiert ist. Bei Textfeldern (ja/nein) bricht DuckDB mit einem
Fehler ab, andere Systeme (etwa SQLite) rechnen stillschweigend mit 0.
Immer den Datentyp prüfen, bevor man arithmetische Aggregatfunktionen einsetzt.
Für Fortgeschrittene
MEDIAN(x) ist in Standard-SQL nicht definiert; in DuckDB
funktioniert es nativ. In anderen Systemen (etwa PostgreSQL) braucht man
PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY x), SQLite kennt ohne Erweiterung
gar keinen Median; gut zu wissen, wenn man die
Abfrage später auf einen echten Klinikserver überträgt.
4 JOIN: Tabellen verbinden
Ein JOIN verbindet zwei Tabellen über einen gemeinsamen Schlüssel:
SELECT k.patient_id, k.aufnahmegrund, k.alter, l.laktat_mmol_l
FROM kohorte  AS k
LEFT JOIN labor AS l ON k.patient_id = l.patient_id
WHERE l.laktat_mmol_l IS NOT NULL;
Achtung: Die WHERE-Bedingung auf eine Spalte der rechten Tabelle wirft die
NULL-Zeilen wieder hinaus; das Ergebnis gleicht damit einem INNER JOIN auf
gemessene Werte (414 statt 500 Zeilen). Hier ist das gewollt, weil nur
gemessene Laktatwerte interessieren. Sollen alle Patient:innen erhalten
bleiben, gehört die Bedingung in die ON-Klausel oder entfällt.
| JOIN-Typ | Ergebnis |
|---|---|
INNER JOIN |
Nur Zeilen, die in beiden Tabellen vorhanden sind |
LEFT JOIN |
Alle Zeilen aus der linken Tabelle; rechts: NULL wenn kein Match |
RIGHT JOIN |
Alle aus der rechten; selten nötig (stattdessen die Tabellen tauschen) |
FULL OUTER JOIN |
Alle Zeilen beider Tabellen |
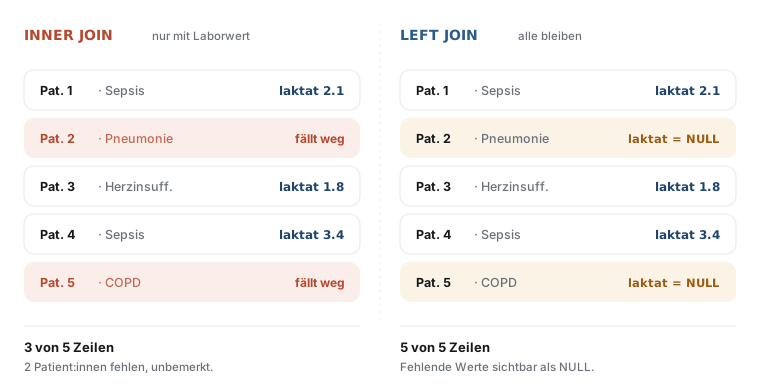
Faustregel: In der klinischen Forschung fast immer LEFT JOIN: du willst
alle Patient:innen behalten, auch wenn ein Laborwert fehlt.
Ein INNER JOIN auf labor verwirft stillschweigend alle
Patient:innen, die in labor keine Zeile haben, ganz ohne Fehlermeldung.
Ein fehlender Wert in einer vorhandenen Zeile (NULL) ist etwas anderes: Im
Kursdatensatz hat jede Patient:in eine Laborzeile, das fehlende Laktat steht
dort als NULL, und ein INNER JOIN behält alle 500. In echten Klinikexporten
fehlen dagegen oft ganze Zeilen. Zähle COUNT(*) vor und nach dem JOIN.
Für Fortgeschrittene
Nach einem LEFT JOIN sind fehlende Werte der rechten Tabelle
als NULL erkennbar. Mit WHERE l.laktat_mmol_l IS NULL lassen sich genau die
Patient:innen ohne Laborwert selektieren, nützlich zur Missingness-Analyse.
Der vollständige Code mit allen Abfragen steht in code/sql.sql,
code/python.py und code/r.R.
5 Abfragen kombinieren
SQL-Abfragen können verschachtelt werden (Subqueries) oder mit WITH als
Common Table Expressions (CTEs) lesbar strukturiert werden:
-- CTE: first identify Sepsis patients, then evaluate their lactate
WITH sepsis_pts AS (
    SELECT patient_id
    FROM kohorte
    WHERE aufnahmegrund = 'Sepsis'
)
SELECT
    ROUND(AVG(l.laktat_mmol_l), 2) AS laktat_mittel,
    COUNT(*)                         AS n
FROM labor AS l
INNER JOIN sepsis_pts AS s ON l.patient_id = s.patient_id
WHERE l.laktat_mmol_l IS NOT NULL;
Verschachtelte Subqueries lesen und debuggen sich schlecht. CTEs benennen jeden Schritt, leichter zu schreiben und sechs Monate später noch nachzuvollziehen.
Für Fortgeschrittene
Mehrere CTEs lassen sich verketten (WITH a AS (…), b AS (…)),
was komplexe Analysepipelines direkt in SQL abbildbar macht, ähnlich wie dplyr-Pipes
in R.
Fallstricke und Merksätze
-
NULList nicht0.WHERE laktat IS NOT NULLexplizit formulieren. Aggregatfunktionen ignorierenNULLautomatisch, aberCOUNT(*)zählt alle Zeilen,COUNT(spalte)nur Nicht-NULL-Werte. -
LEFT JOINvs.INNER JOIN: EinINNER JOINauflaborschließt Patient:innen ohne Laborzeile still aus; in einer klinischen Kohorte ist das fast immer ein Fehler. -
Reihenfolge der Klauseln: geschrieben wird
SELECT → FROM → WHERE →
 GROUP BY → HAVING → ORDER BY → LIMIT
, ausgewertet aberFROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT. Deshalb prüft SQLHAVINGerst nach dem Gruppieren, und ein Alias ausSELECTtaugt inORDER BY, inWHEREaber nicht. -
DuckDB und Daten: Ein DataFrame erst mit
pandas/readrladen (auch von einer Web-Adresse) und dann mitcon.register()/duckdb_register()sichtbar machen, keine Datei nötig. Alternativ liest DuckDBsread_csv_auto()auch direkt CSV-Pfade, lokal ohne Zusatzschritt, von einer URL über die Erweiterunghttpfs. Neuere DuckDB-Versionen laden sie beim ersten Zugriff automatisch nach, brauchen dafür aber Internet; sonst einmaligINSTALL httpfs; LOAD httpfs;. - Spaltenaliase (
AS anzahl) verbessern Lesbarkeit und sind inORDER BYreferenzierbar.
Selbstcheck
INNER JOIN gibt nur Zeilen zurück, die in beiden Tabellen einen Match haben; hat eine Patient:in keine Laborzeile, fällt sie raus (eine vorhandene Zeile mit NULL-Wert genügt dagegen für den Match), bei klinischen Kohorten fast immer unbeabsichtigt.WHERE filtert vor der Aggregation auf Zeilenebene; HAVING filtert nach GROUP BY auf Gruppenebene.COUNT(laktat_mmol_l) zählt nur Nicht-NULL-Werte (~83 % der Zeilen); COUNT(*) zählt alle Zeilen unabhängig von NULL.