Teil 5 – Machine Learning und KI in der Medizin
34 · Studiendesign zur Validierung klinischer KI-Systeme
- Den Unterschied zwischen retrospektiver Validierung und prospektiver klinischer Evaluation erklären.
- Das Konzept des Schattenbetriebs (Silent Deployment) zur risikoarmen Datenerfassung beschreiben.
- Spezifische Bias-Quellen beim Einsatz von KI im Krankenhaus (Automation Bias, Spectrum Bias, Alarm-Müdigkeit) identifizieren.
- Studiendesigns zur Evidenzgenerierung für klinische Entscheidungsunterstützungssysteme (CDSS) entwerfen.
- Die wichtigsten Berichtsstandards (TRIPOD+AI, DECIDE-AI, CONSORT-AI) kennen.
Auf dieser Seite
Klinischer Aufhänger
Dein Sepsis-Vorhersagemodell hat retrospektiv eine beeindruckende AUC von 0,89 erzielt. Nun soll das System als klinisches Entscheidungsunterstützungssystem (CDSS) auf der Intensivstation eingeführt werden und Ärzt:innen per SMS warnen. Der Chefarzt fragt: „Verbessert dieses System tatsächlich das Überleben der Patient:innen oder führt es nur zu mehr Fehlalarmen und zusätzlichem Stress?“ Um diese Frage zu beantworten, musst du eine klinische Studie konzipieren, die über rein statistische Metriken hinausgeht.
1 Prospektive vs. Retrospektive Validierung
Ein Modell, das auf historischen Daten hervorragend abschneidet, kann im echten Klinikalltag aus mehreren Gründen versagen:
- Dataset Shift: Die Patient:innenpopulation oder Dokumentationspraxis hat sich seit der Datensammlung verändert.
- Fehlende Interaktion: Retrospektive Daten zeigen nicht, wie Ärzt:innen reagieren, wenn sie einen Alarm erhalten.
- Klinischer Nutzen: Eine hohe AUC bedeutet nicht automatisch, dass Patient:innen früher behandelt werden oder seltener sterben.
| Validierungsart | Datenquelle | Zielgrößen | Risiko für Patient:innen |
|---|---|---|---|
| Retrospektiv | Historische Datenbanken | AUC, Kalibrierung, Sensitivität | Keine |
| Prospektiv (Silent) | Live-Daten im Hintergrund | Stabilität der Metriken, Drift | Keine |
| Klinische Studie | Live-Einsatz am Krankenbett | Mortalität, Liegedauer, Time-to-Antibiotics | Vorhanden (Fehldiagnose/Therapieverzögerung) |
2 Der Schattenbetrieb (Silent Deployment)
Bevor eine KI Patient:innen beeinflusst, sollte sie im Schattenbetrieb (Silent Deployment) laufen.
- Das Modell erhält Live-Daten aus dem Krankenhausinformationssystem (KIS, z. B. via FHIR-Schnittstelle) und berechnet Risikoscores.
- Niemand sieht diese Scores – weder Pflegende noch Ärzt:innen. Es erfolgt keine Intervention.
- Die Scores und die tatsächlichen klinischen Outcomes werden protokolliert.
Nutzen des Schattenbetriebs
- Technische Validierung: Läuft die Pipeline stabil und ohne relevante Verzögerung?
- Prospektive Baseline: Entspricht die prospektive AUC der retrospektiven?
- Kalibrierungs-Check: Stimmen die vorhergesagten Wahrscheinlichkeiten auch im Live-Betrieb?
Für Fortgeschrittene
Punkt 3 ist der unterschätzte Fall. Diskriminierung (AUC) und Kalibrierung (stimmen vorhergesagte Wahrscheinlichkeiten mit der beobachteten Ereignisrate überein?) können sich unabhängig voneinander verändern. Die Simulation unten zeigt genau das an der Kurskohorte: Ein Modell wird an zwei Dritteln der Patient:innen entwickelt und eingefroren; an jedem dritten Fall (patient_id durch 3 teilbar) wird es validiert. Danach steigt das wahre Sterberisiko Monat für Monat bei gleichem Merkmalsprofil, etwa durch einen aggressiveren Erregerstamm oder eine geänderte Zuweisungspraxis, also durch Einflüsse, die das Modell nicht sieht. Technisch steigen die Log-Odds des Todes um 0,15 pro Monat; simuliert wird das ohne Zufall, indem jeder beobachtete Todesfall der Validierungsgruppe mit dem Gewicht exp(0,15 · Monat) zählt.
Hinweis – die Codeblöcke unten sind Auszüge. Sie zeigen die entscheidenden Schritte, nicht jede Import-Zeile. Das vollständige, am Stück lauffähige Skript ist
code/python.py(im Browser über den Python-Reiter oben). In Colab führst du das ganze Modul mit einer Zeile aus:!python module/34-design-ki-studien/code/python.py– siehe das in Colab öffnen.
.py schreiben und mit dem ▶-Knopf in VS Code ausführen – oder Zeile für Zeile in die Python-Konsole. Setzt die in Modul 02 eingerichtete Umgebung voraus.# Fit once on the development patients and freeze the model; then the true # risk drifts: log-odds of death +0.15 per month at every feature profile, # simulated by giving each observed death the weight exp(delta). # Full code: code/python.py (function simulate_drift()). model = sm.GLM(y_dev, X_dev, family=sm.families.Binomial()).fit() p = np.asarray(model.predict(X_test)) # identical in every month for month in range(7): w = np.where(y_test == 1, np.exp(0.15 * month), 1.0) observed = np.sum(w * y_test) / np.sum(w) predicted = np.sum(w * p) / np.sum(w) auc = roc_auc_score(y_test, p, sample_weight=w) print(month, round(observed / predicted, 3), round(auc, 3)) # O:E rises, AUC does not
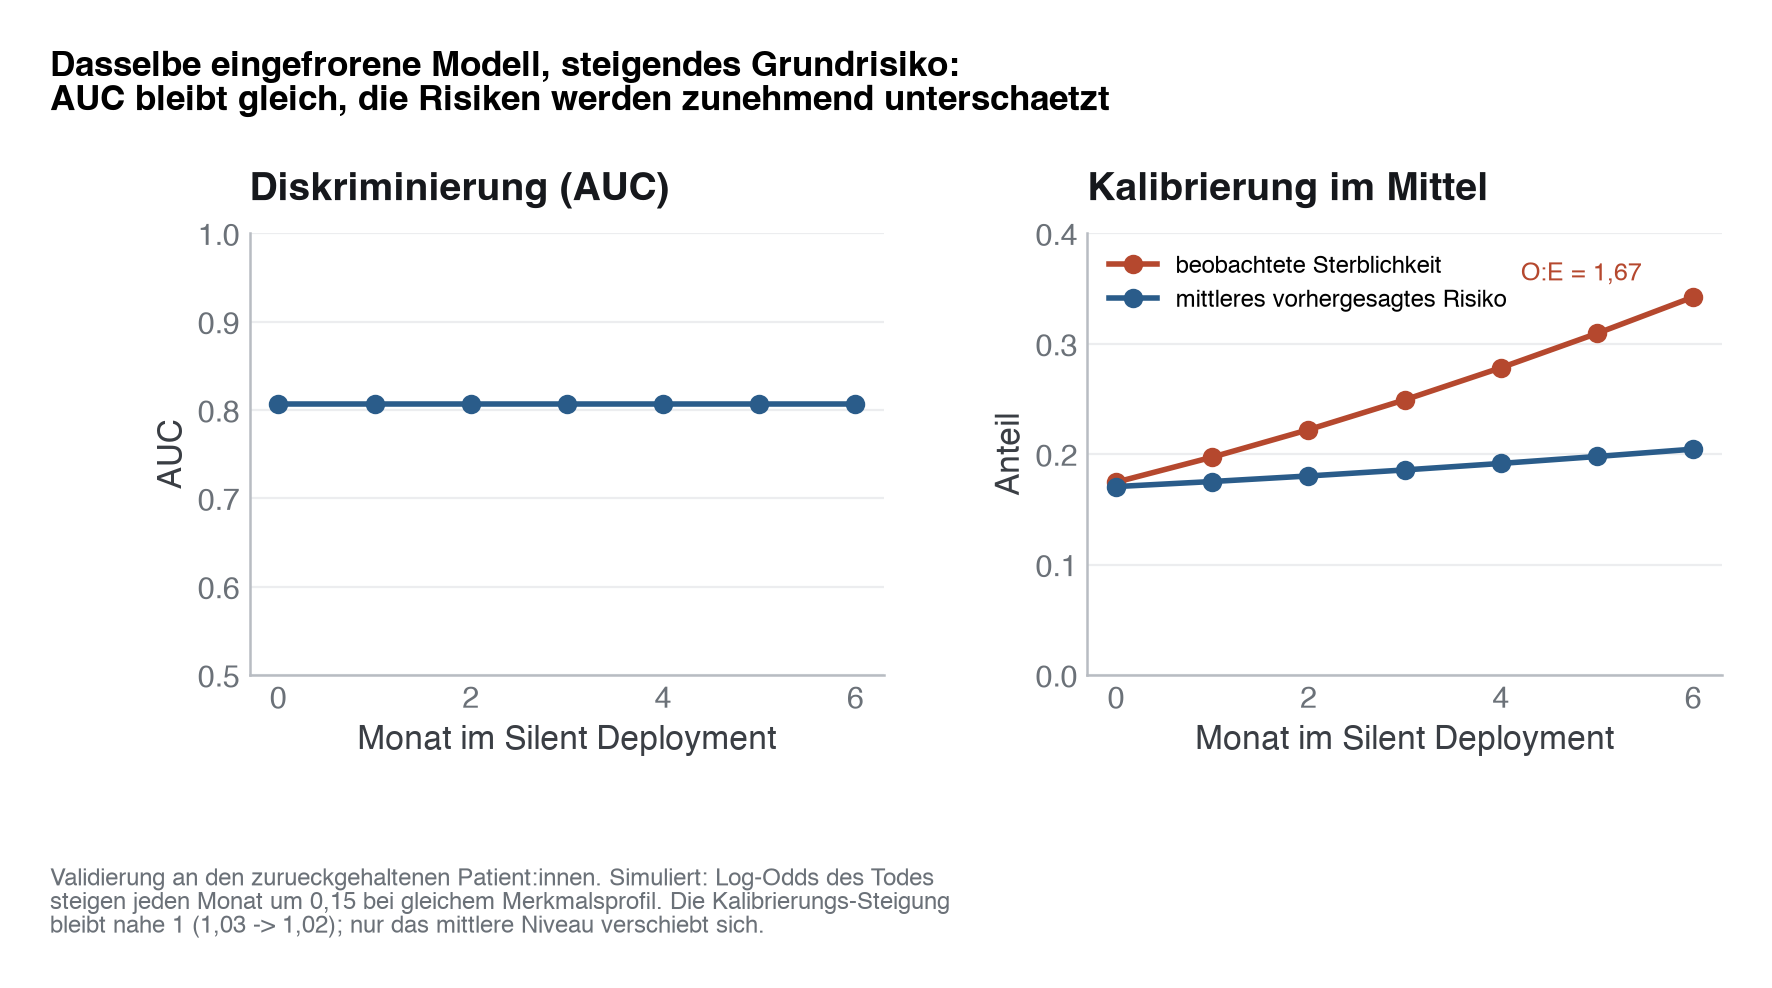
code/python.py und code/r.R liefern identische Zahlen (Auszug):
| Monat | beobachtete Sterblichkeit | mittleres vorhergesagtes Risiko | O:E | Kalibrierungs-Steigung | AUC | Brier Score |
|---|---|---|---|---|---|---|
| 0 | 0,175 | 0,171 | 1,023 | 1,026 | 0,807 | 0,114 |
| 2 | 0,222 | 0,180 | 1,232 | 1,025 | 0,807 | 0,135 |
| 4 | 0,278 | 0,192 | 1,452 | 1,024 | 0,807 | 0,160 |
| 6 | 0,342 | 0,205 | 1,673 | 1,020 | 0,807 | 0,189 |
Im Monat 0 ist das Modell gut kalibriert (O:E ≈ 1, Steigung ≈ 1). Danach bleibt die AUC unverändert, weil sich an der Rangfolge der Patient:innen nichts ändert, und auch die Kalibrierungs-Steigung bleibt nahe 1. Gestört ist die Kalibrierung im Mittel (calibration-in-the-large): Nach sechs Monaten sterben 1,67-mal so viele Patient:innen, wie das Modell erwartet. Das mittlere vorhergesagte Risiko steigt leicht mit, weil unter den zusätzlichen Todesfällen Hochrisikoprofile häufiger sind; die beobachtete Sterblichkeit wächst aber deutlich schneller. Ein AUC-Monitoring allein hätte nichts gemeldet; ein Abgleich von beobachteter und erwarteter Ereignisrate zeigt eine von Monat zu Monat wachsende Lücke (bei kleinen Fallzahlen pro Monat allerdings mit breitem Unsicherheitsband). Weil nur das Niveau verschoben ist, würde hier eine Neuschätzung des Intercepts (Rekalibrierung) genügen.
Der Brier Score steigt in der Tabelle ebenfalls (0,114 → 0,189), taugt aber nicht als alleiniges Kalibrierungsmaß: Er wächst auch dann, wenn ein perfekt kalibriertes Modell auf eine Population mit höherer Ereignisrate (unterhalb von 50 %) trifft, weil die Ereignisse dann schlicht schwerer vorherzusagen sind. Für das Monitoring gehören O:E (bzw. beobachtete vs. mittlere vorhergesagte Rate) und die Kalibrierungs-Steigung oder -Kurve dazu. Umgekehrt entkalibriert eine reine Verschiebung der erfassten Merkmale (etwa höhere SOFA-Scores bei unverändertem Zusammenhang zwischen SOFA und Sterblichkeit) ein gut spezifiziertes Modell kaum; gefährlich sind Veränderungen, die das Modell nicht sehen kann.
Ein Silent Deployment prüft, ob ein Modell noch läuft, und ebenso, ob seine Wahrscheinlichkeiten noch stimmen. Eine stabile AUC ist keine Garantie für stabile Kalibrierung.
3 Bias-Quellen im klinischen Einsatz
Bei der Interaktion zwischen Mensch und Maschine treten spezifische psychosoziale und methodische Effekte auf:
- Automation Bias: Das blinde Vertrauen in die Maschine. Ärzt:innen übersehen eigene klinische Warnsignale, weil die KI „grünes Licht“ gibt.
- Spectrum Bias: Das Modell wurde an schwerkranken Intensivpatient:innen trainiert, wird aber nun auf einer Normalstation eingesetzt, wo das Patient:innenspektrum völlig anders ist. Der Anteil der Fehlalarme an allen Alarmen steigt drastisch (der positive Vorhersagewert sinkt), schon weil die Prävalenz niedriger ist; zusätzlich verschieben sich im anderen Spektrum meist auch Sensitivität und Spezifität.
- Alarm-Müdigkeit (Alert Fatigue): Wenn 90 % der Alarme Fehlalarme sind, ignorieren Ärzt:innen das System irgendwann komplett – auch die echten Warnungen.
Spectrum Bias ist nicht dasselbe wie die Kalibrierungsdrift aus Abschnitt 2 – Spectrum Bias verschiebt die Population, auf der ein Modell überhaupt eingesetzt wird (Intensivstation vs. Normalstation), während die Kalibrierungsdrift auch innerhalb derselben Station über die Zeit auftritt, wenn sich Grundrisiko oder nicht erfasste Einflussgrößen schrittweise verändern. Beide führen zum selben Symptom: Vorhersagen, die nicht mehr zur beobachteten Ereignisrate passen.
4 Studiendesigns für klinische KI
Um den echten Nutzen nachzuweisen, reichen statistische Modelltests nicht. Es braucht interventionelle Studien:
- Vorher-Nachher-Vergleich: Einfach zu implementieren, aber anfällig für historische Trends (z. B. Einführung neuer Leitlinien zeitgleich mit der KI).
- Cluster-randomisierte Studien (cRCT): Die Randomisierung erfolgt nicht pro Patient:in (da Ärzt:innen sich durch das System beeinflussen lassen und dieses Wissen auf alle Patient:innen übertragen), sondern pro Station oder Klinik. Station A nutzt das System, Station B arbeitet standardmäßig.
- Nicht-Unterlegenheits-Studien: Nachweis, dass der Einsatz der KI die Behandlungsqualität zumindest nicht verschlechtert, aber z. B. Ressourcen schont.
Die Wahl des Studiendesigns hängt vom Reifegrad des Systems ab: ein brandneues Modell durchläuft typischerweise erst Silent Deployment (Abschnitt 2), dann eine frühe klinische Evaluation in kleinem Rahmen (Nutzung, Sicherheit, Human Factors; berichtet nach DECIDE-AI), erst danach eine vergleichende Studie wie eine cRCT, idealerweise multizentrisch. Ein Sprung direkt zur klinischen Studie ohne Schattenbetrieb überspringt genau die Phase, in der technische Fehler und Kalibrierungsprobleme am billigsten zu entdecken sind.
Wann du Hilfe holst. Der Sprung von retrospektiver AUC zur prospektiven Wirksamkeitsstudie ist ein eigenes Studiendesign mit eigener Fallzahl, Randomisierung und Ethikvotum – hol Biostatistik, Studienmethodik und Ethikkommission an Bord, bevor ein CDSS am Krankenbett Alarme auslöst.
Fallstricke und Merksätze
AUC ist kein klinischer Endpunkt. Für die CE-Kennzeichnung als Medizinprodukt verlangt die MDR eine klinische Bewertung, die Leistung, Sicherheit und klinischen Nutzen belegt (Art. 61 MDR); eine retrospektive AUC von 0,90 reicht dafür allein nicht aus. Ob Patient:innen vom Einsatz tatsächlich profitieren, zeigt erst eine Studie mit klinischen Endpunkten.
Berichtsstandards nutzen: - TRIPOD+AI: Für die Entwicklung und Validierung des Algorithmus. - DECIDE-AI: Für die Evaluation in frühen klinischen Phasen. - CONSORT-AI: Für randomisierte kontrollierte Studien mit KI-Beteiligung; das zugehörige Studienprotokoll folgt SPIRIT-AI.