Teil 5 – Machine Learning und KI in der Medizin
28 · Maschinelles Lernen für Überlebenszeiten
- Verstehen, warum klassische ML-Klassifikatoren Zensierung ignorieren und warum das zählt.
- Random Survival Forests (RSF) trainieren und interpretieren.
- Zeitabhängige AUC (
cumulative_dynamic_auc) berechnen und gegen Cox-Baseline vergleichen. - Kaplan-Meier-Kurven nach modellbasierter Risikogruppe darstellen.
- Die Konzepte Zensierung, zeitvariantes Risiko und konkurrierende Risiken einordnen.
Auf dieser Seite
Klinischer Aufhänger
„Wie hoch ist das 7-Tage-Sterberisiko, und ändert sich diese Schätzung, wenn der Patient noch 14 Tage überlebt?“ Cox (Modul 12 und 17) nimmt proportionale Hazards und, ohne Zusatzterme, lineare Effekte an. Moderne Überlebens-ML lockert beide Annahmen: Das Risiko kann sich über die Zeit verschieben, und ein Random Survival Forest findet nichtlineare Interaktionen ohne manuelles Feature Engineering. Für Intensivstationen mit stark variierender Verweildauer ist das klinisch relevant.
1 Warum nicht einfach einen Klassifikator nehmen?
Ein LogisticRegression oder RandomForest, der verstorben_30d als 0/1 lernt,
ignoriert, wann das Ereignis eintrat. Patient A, der am Tag 2 stirbt, und
Patient B, der am Tag 29 stirbt, bekommen dieselbe Label-1, obwohl ihr Risikoprofil
zu Tag 7 fundamental verschieden ist. Noch gravierender: Patient C, der am Tag 10
lebend aus der Nachbeobachtung fällt (z. B. Verlegung ohne weitere Rückmeldung),
ist zensiert, er hatte keine 30 Tage Beobachtungszeit, und ein Klassifikator
kodiert ihn falsch als Nicht-Ereignis.
Hinweis – die Codeblöcke unten sind Auszüge. Sie zeigen die entscheidenden Schritte, nicht jede Import-Zeile. Das vollständige, am Stück lauffähige Skript ist
code/python.py(im Browser über den Python-Reiter oben). In Colab führst du das ganze Modul mit einer Zeile aus:!python module/28-survival-ml/code/python.py– siehe das in Colab öffnen.
.py schreiben und mit dem ▶-Knopf in VS Code ausführen – oder Zeile für Zeile in die Python-Konsole. Setzt die in Modul 02 eingerichtete Umgebung voraus.# Wrong: ignores censoring and event timing. # clf.fit(X, df["verstorben_30d"]) <- this discards information # Correct: use survival-aware models that use (time, event) pairs. # survival_y = [(bool(event), float(time)) for event, time in zip(events, times)]
Wer zensierte Patient:innen als Nicht-Ereignis kodiert, unterschätzt das Risiko systematisch, umso stärker, je mehr Patient:innen vor dem Horizont aus der Beobachtung fallen.
Für Fortgeschrittene
Für sehr kurze, feste Horizonte (z. B. 24-h-ICU-Mortalität ohne Zensierung) kann ein einfacher Klassifikator akzeptabel sein, aber nur wenn wirklich alle Patient:innen vollständig beobachtet wurden.
2 Random Survival Forests
RSF baut Entscheidungsbäume, die statt des Gini-Index den Log-Rank-Test als Splitkriterium nutzen, so werden Zensierung und Eventzeit korrekt berücksichtigt. Jeder Baum gibt eine kumulative Hazardfunktion pro Patient:in zurück; der Forest mittelt diese Schätzungen.
.py schreiben und mit dem ▶-Knopf in VS Code ausführen – oder Zeile für Zeile in die Python-Konsole. Setzt die in Modul 02 eingerichtete Umgebung voraus.# scikit-survival (sksurv) – preferred try: from sksurv.ensemble import RandomSurvivalForest from sksurv.metrics import cumulative_dynamic_auc # survival_y is a structured array: (event: bool, time: float) rsf = RandomSurvivalForest(n_estimators=200, min_samples_leaf=10, random_state=SEED, n_jobs=-1) rsf.fit(X_train, survival_y_train) SKSURV_AVAILABLE = True except ImportError: # Fallback: Cox + HistGradientBoosting classifier at fixed horizon SKSURV_AVAILABLE = False
In R nutzt du ranger mit einer Surv()-Formel (Splitregel logrank,
optional importance="permutation") oder das Paket randomForestSRC für
vollständige RSF-Unterstützung.
RSF mit vielen Bäumen und kleinen Blättern ist langsam.
min_samples_leaf=10 ist ein guter Startpunkt für kleine Kohorten (< 1000).
Für Fortgeschrittene
predict_cumulative_hazard_function liefert pro
Patient:in eine komplette Kurve über die Zeit, das erlaubt zeitabhängige
Entscheidungen statt nur einen festen 30-Tage-Score.
3 Zeitabhängige AUC
Eine einzige AUC misst die Diskriminierung an einem fixen Horizont. Die
zeitabhängige AUC (cumulative_dynamic_auc) berechnet die Fläche unter
der ROC-Kurve für jeden Zeitpunkt t, sie zeigt, ob das Modell auch an Tag 7,
14 oder 21 noch gut diskriminiert, nicht nur am Ende des Beobachtungsfensters.
.py schreiben und mit dem ▶-Knopf in VS Code ausführen – oder Zeile für Zeile in die Python-Konsole. Setzt die in Modul 02 eingerichtete Umgebung voraus.# With sksurv: times = [7, 14, 21, 28] auc_values, mean_auc = cumulative_dynamic_auc(survival_y_train, survival_y_test, risk_scores, times) for t, a in zip(times, auc_values): print(f" AUC @ t={t:2d}d: {a:.3f}") print(f" Mean AUC: {mean_auc:.3f}") # Point estimates ALONE are not enough: on n=125 with only 19 events # (only a handful of them by day 7) they are extremely noisy. code/python.py # bootstraps the test set and reports a 95% CI per time point plus a CI # for the Cox-minus-RSF difference.
In R berechnet timeROC denselben Estimand (nicht nur Harrells C-Index) und
liefert das Konfidenzintervall gleich mit:
library(timeROC)
td <- timeROC(T = test$fu_zeit_tage, delta = test$status,
              marker = cox_lp, cause = 1, times = c(7, 14, 21, 28), iid = TRUE)
ci <- confint(td)$CI_AUC / 100            # 95% CI per time point (percent -> proportion)
cbind(AUC = td$AUC, KI_unten = ci[, 1], KI_oben = ci[, 2])
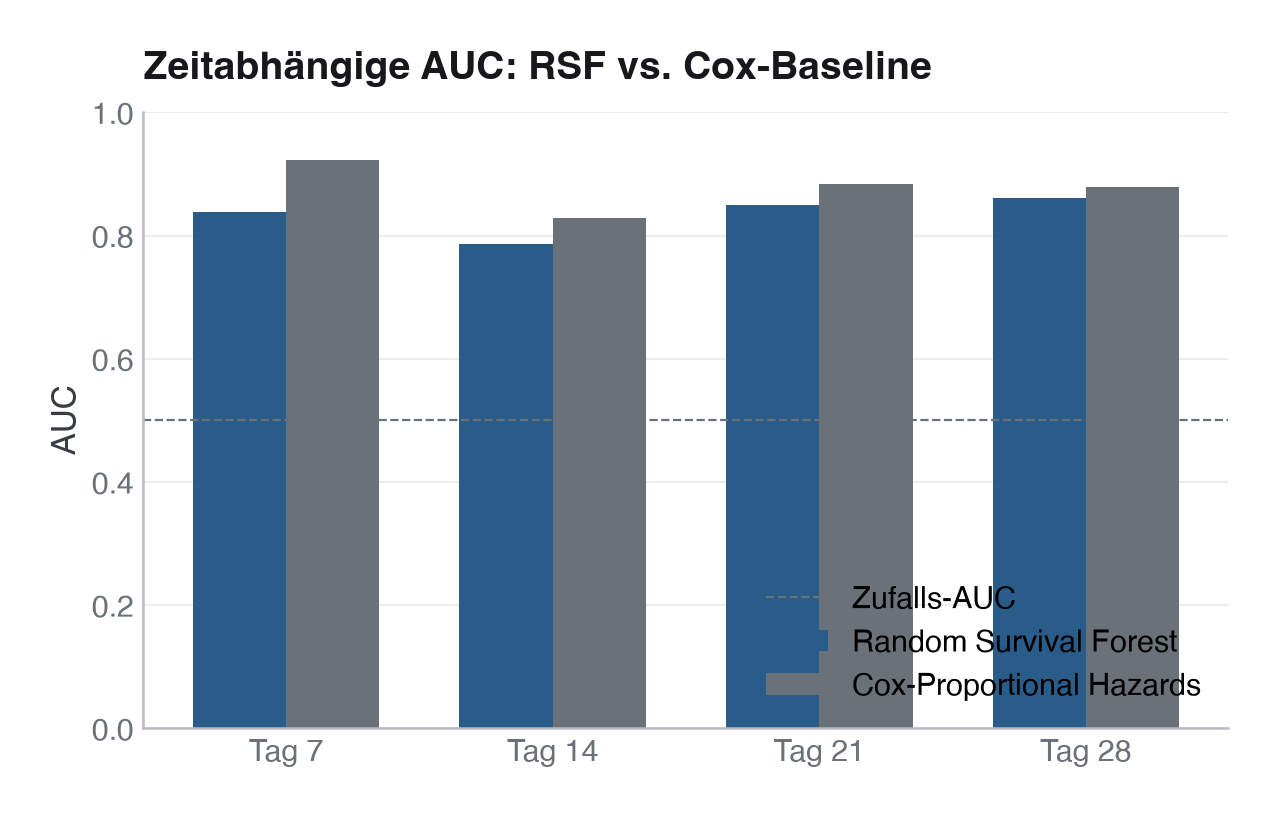
Auf dieser Kohorte (500 Patient:innen, 78 Ereignisse, 75/25-Split, Testsatz n = 125 mit 19 Ereignissen) ergibt der tatsächliche Lauf als Punktschätzer: RSF-AUC ≈ 0,84 (Tag 7), 0,79 (Tag 14), 0,85 (Tag 21), 0,86 (Tag 28); Cox ≈ 0,92 (Tag 7), 0,83 (Tag 14), 0,88 (Tag 21), 0,88 (Tag 28). Auf den ersten Blick liegt Cox überall etwas höher. Der Bootstrap zeigt aber: die 95%-KI der Differenz (Cox − RSF) schließen bei Tag 14, 21 und 28 die Null ein (z. B. Tag 28: +0,02 [−0,02, +0,06]) – dort ist der Unterschied von Stichprobenrauschen nicht zu unterscheiden. Nur am frühesten, ereignisärmsten Horizont (Tag 7: +0,09 [+0,02, +0,15]) liegt das Intervall knapp über null; und gerade dieser Bootstrap hält die trainierten Modelle fest, misst also nur die Test-Stichprobenstreuung und unterschätzt die Unsicherheit noch. Belastbar ist darum nur: kein Modell ist hier klar überlegen. RSF ist nicht automatisch überlegen – bei kleinen Kohorten und näherungsweise proportionalen Hazards kann eine gut regularisierte Cox-Baseline mithalten –, aber genauso wenig lässt sich hier ein Cox-Vorsprung nachweisen. RSFs eigentlicher Vorteil liegt bei nichtlinearen Zusammenhängen, Interaktionen und größeren Stichproben.
cumulative_dynamic_auc aus sksurv erwartet strukturierte
NumPy-Arrays (event: bool, time: float). Normale Python-Tuples werden nicht
akzeptiert, np.dtype([("event","?"),("time","<f8")]) ist die korrekte Form.
Übergib das vollständige Test-Array und den
vollständigen Score-Vektor an cumulative_dynamic_auc (zusammen mit der
Liste aller Zeitpunkte), die Funktion baut das Risk-Set pro Zeitpunkt intern
auf. Wer stattdessen vorab nach zeit >= t filtert und die gefilterten Arrays
einzeln pro Zeitpunkt übergibt, bekommt entweder einen ValueError („times
must be within follow-up time of test data“) oder, schlimmer, unbemerkt
verzerrte (zu hohe) AUC-Werte, weil das Risk-Set dann unvollständig ist.
Für Fortgeschrittene
Die mittlere AUC fasst gut zusammen; für klinische Entscheidungen an Tag 7 (z. B. ICU-Entlassung) zählt aber der zeitpunktspezifische Wert.
4 Risikogruppen mit Kaplan-Meier
Modellvorhersagen werden in Tertile eingeteilt (niedrig / mittel / hoch) und mit Kaplan-Meier visualisiert. Das erlaubt einen klinisch intuitiven Vergleich: Trennen die Risikogruppen die Überlebenskurven klar?
.py schreiben und mit dem ▶-Knopf in VS Code ausführen – oder Zeile für Zeile in die Python-Konsole. Setzt die in Modul 02 eingerichtete Umgebung voraus.from lifelines import KaplanMeierFitter for label, mask in [("Niedrig", risk_low), ("Mittel", risk_mid), ("Hoch", risk_high)]: kmf = KaplanMeierFitter() kmf.fit(durations=times_test[mask], event_observed=events_test[mask], label=label) kmf.plot_survival_function(ax=ax)
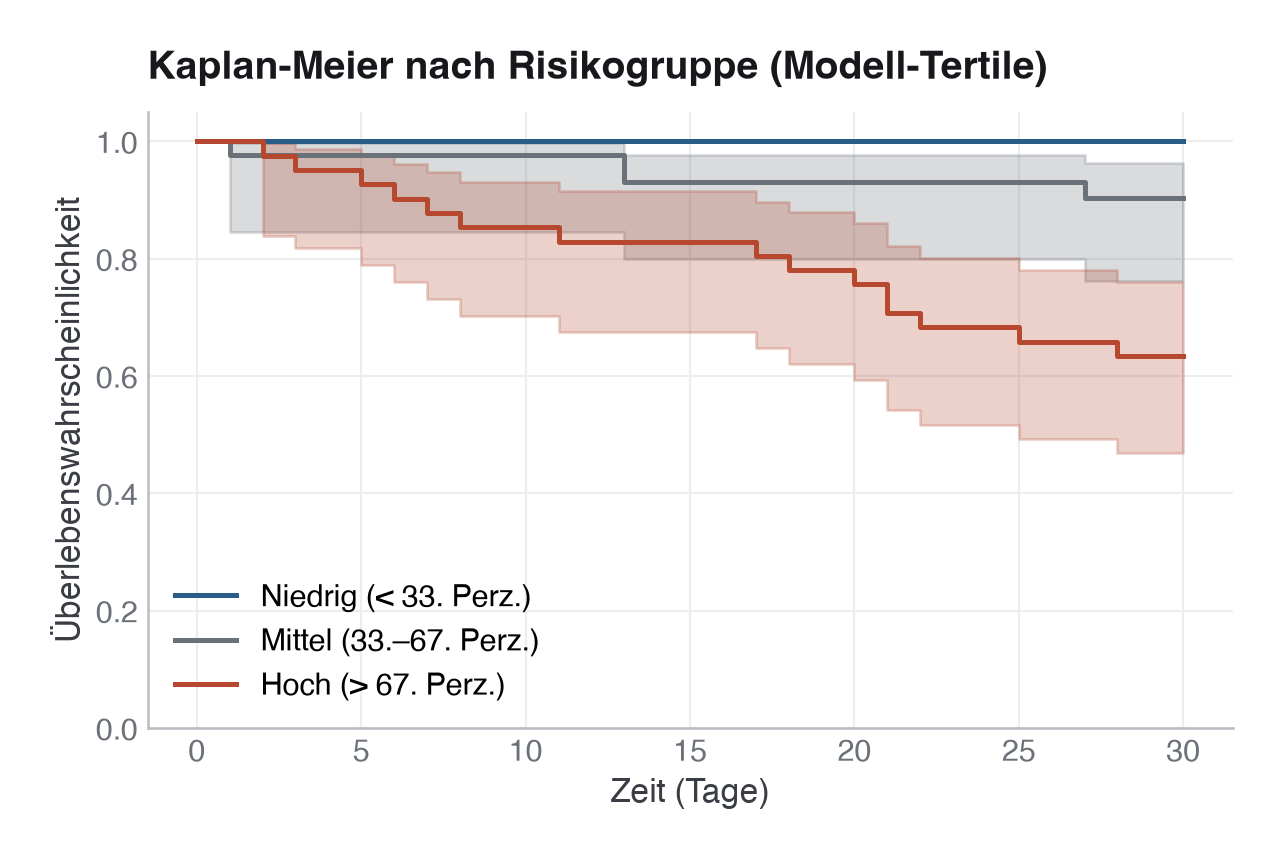
Risikogruppen-Tertile nach dem Modell-Score einteilen, nicht nach dem beobachteten Outcome, sonst optimierst du die Visualisierung auf dem Testset und täuschst dich über die echte Trennschärfe.
Für Fortgeschrittene
Log-Rank-Test zwischen den Gruppen quantifiziert, ob die Trennung statistisch überzufällig ist; die Hazard Ratio zwischen dem oberen und unteren Tertil ist ein gängiges Reportingmaß.
Auf Station reicht selten „hohes Risiko“ als Label, kommuniziere mit, wie hoch (z. B. „30-Tage-Überlebenswahrscheinlichkeit ≈ 65 %, 95 %-KI 47–76 %“) und für welchen Zeitraum die Kurve gilt, sonst wird die Risikogruppe leicht mit einer festen Prognose verwechselt.
5 Zensierung, zeitvariantes Risiko, konkurrierende Risiken
Zensierung tritt auf, wenn die Beobachtung endet, bevor das Ereignis eintritt (z. B. Studienende oder Verlust der Nachbeobachtung). Das Modell muss wissen, dass diese Person zum letzten Kontakt noch lebte, ohne anzunehmen, sie sterbe danach nie. Die Entlassung ist nur dann eine Zensierung, wenn die Nachbeobachtung dort endet, und selbst dann wahrscheinlich eine informative (Entlassene sind im Mittel gesünder); in Modul 20 ist sie deshalb ein Konkurrenzereignis.
Zeitvariantes Risiko: Das Tagesrisiko kann sich verschieben, ein Patient kann
in der ersten Woche kritisch, danach stabil sein. Klassische Cox-Modelle
erlauben zeitvariante Kovariaten (tstart/tstop-Format). Gängige
RSF-Implementierungen (sksurv, randomForestSRC) arbeiten dagegen nur mit
Baseline-Merkmalen; zeitvariante Information braucht dort Landmarking oder
spezialisierte Erweiterungen.
Konkurrierende Risiken: Wenn ein Patient wegen einer anderen Ursache stirbt (oder transplantiert wird), kann er das Ziel-Ereignis nicht mehr erleiden. Der Kaplan-Meier-Ansatz (1 − KM) überschätzt dann das Risiko; der Aalen-Johansen-Schätzer oder das Fine-Gray-Modell sind korrekte Alternativen.
# R concept: competing risks with cmprsk or tidycmprsk
# library(cmprsk)
# cuminc(ftime, fstatus, group) where fstatus = 1 (event), 2 (competing), 0 (censored)
Einfaches KM bei konkurrierenden Risiken überschätzt das kumulierte Risiko, oft erheblich bei älteren Kohorten mit Mehrfacherkrankungen.
Für Fortgeschrittene
Das Fine-Gray-Modell gibt eine subdistribution hazard ratio, die direkt für Risikoscores mit konkurrierenden Risiken genutzt werden kann.
Wann du Hilfe holst. Bei wenigen Ereignissen, konkurrierenden Risiken oder wenn ein Random Survival Forest klinisch eingesetzt werden soll, reicht die zeitabhängige AUC allein nicht – Estimand, Zensierungsannahmen und externe Validierung gehören mit einer Biostatistikerin geklärt.
Fallstricke und Merksätze
-
Klassifikator ≠ Überlebensanalyse. Ohne Zensierungsinformation ist der Label-1-Trick systematisch falsch.
-
Zeitabhängige AUC statt einmaliger AUC bei variierendem Beobachtungsfenster.
-
Risikogruppen-Tertile nach Score, nicht nach Outcome einteilen, sonst garantierte Überanpassung.
-
Konkurrierende Risiken ignorieren macht das kumulierte Risiko zu hoch.
- RSF ist keine Black Box gegenüber Cox, Permutation Importance und PDPs lassen sich auch für RSF berechnen; die Logik aus Modul 27 lässt sich übertragen.
Ein flexibleres Modell (RSF) gewinnt nicht automatisch gegen eine einfache Baseline (Cox), immer beide gegeneinander evaluieren, statt die komplexere Methode blind zu bevorzugen, das gilt in der Überlebensanalyse genauso wie im Rest des maschinellen Lernens.